🌱 从录音到开口说话:VoxCPM2 声音克隆零基础完整教程
适用范围:本教程面向已经拥有本案例 Windows 工程的新手,帮助你从录音开始完成训练与使用。启动菜单和素材整理页面属于这套本地工程,并不是下载任何一份官方源码都会自带的界面。本文不提供未经验证的全新电脑安装步骤;如果没有这套工程,应先完成官方环境安装,再核对入口差异。
🌱 目录
- 先分清三种东西与本案例进度
- 认识目录和启动菜单
- 录音设备与场景测试
- 设计并录制四组正式语料
- 把长录音整理成训练数据
- 进行 LoRA 训练
- 找到并检查模型
- 解决推理页面看不到 LoRA
- 第一次推理与效果对比
- 建立情绪参考音频库
- 常见问题与排错表
- 保存、迁移与完成检查
- 资料来源与证据边界
🌱 一、先分清三种东西与本案例进度
1. 训练素材、LoRA 模型、参考音频不是同一种文件
| 名称 | 是什么 | 什么时候使用 | 不能替代什么 |
|---|---|---|---|
| 训练素材 | 你录的真人声音,以及每个切片对应的准确文字 | 数据整理和训练时 | 不能直接当成训练完成的模型 |
| LoRA 模型 | 训练得到的一小组适配权重及其结构配置 | 推理时与匹配的基础模型一起加载 | 不能脱离基础模型独立运行 |
| 参考音频 | 一小段干净的真人录音,通常配有逐字文本 | 生成时提供音色、节奏、语气等参考 | 不能保证精确控制某一种情绪,也不等于重新训练 |
可以先这样理解:训练素材供模型学习;LoRA 保存这次学习的结果;参考音频给某次生成提供额外示范。LoRA 与参考音频都会影响声音表现,“像谁”和“怎么说”并非完全独立的两个开关。
真人录音 + 准确文字
        ↓ 数据整理、切片与复核
训练数据集 + VoxCPM2 基础模型
        ↓ LoRA 训练
LoRA 权重 + LoRA 配置
        ↓ 与同一基础模型配合
新文本 + 可选参考音频及其原文
        ↓ 推理
生成语音
2. 原对话实际上包含两个阶段
| 阶段 | 原对话记录 | 本教程如何使用 |
|---|---|---|
| 早期训练 | 约 9.9 分钟,导出 65 条训练数据、3 条验证数据;完成 1000 步训练 | 用来说明已跑通的训练流程和模型检查 |
| 后期补充录音 | 更换设备与场景,重新测试后录了四组、合计约 50 分钟 | 用来说明新一轮语料设计;没有证据表明这四组已用于完成新的 VoxCPM2 训练 |
原对话还讨论过另一套 IndexTTS 工程。这里不把它的训练完成日志或权重当作 VoxCPM2 的成果。
如果你现在只想使用已有声音:直接阅读第二章、七至十章,无需重新录音或训练。
如果你要训练新声音:从第三章开始,先备份旧数据,再完成数据整理与新任务训练。新一轮应使用新任务名称,保留旧模型供比较。
🌱 二、认识目录和启动菜单
1. 工程目录怎么分工
在资源管理器地址栏粘贴下面的路径,按回车:
F:\VoxCPM
本案例已核对的主要结构:
F:\VoxCPM
├─ start.bat                     启动菜单;隐藏扩展名时显示为 start
├─ venv                         本工程的 Python 运行环境
├─ pretrained_models
│  └─ VoxCPM2                   基础模型
├─ dataset                      素材整理工作区
│  ├─ wavs                      导入后的解码副本
│  ├─ clips                     切片音频
│  ├─ manifest.json             切片状态、复核结果等
│  ├─ train.jsonl               训练数据清单
│  └─ val.jsonl                 验证数据清单
├─ lora                         素材整理工具输出的训练任务
│  └─ lora_20260822_211954
│     ├─ train_config.yaml       该次训练参数
│     ├─ logs                    日志等
│     └─ checkpoints            模型检查点
├─ VoxCPM_src                   VoxCPM 源码
│  ├─ lora_ft_webui.py          LoRA Training / Inference 页面
│  └─ lora                     当前菜单 4 启动后扫描的位置
├─ dataset_prep_webui.py         本地素材整理与训练工具
├─ web_ui.py                    普通声音克隆页面
└─ clone_voice.py               普通克隆命令行入口
这两个同名目录最容易混淆:上层的是本地素材整理工具的训练输出;源码里面的是当前 LoRA WebUI 启动后扫描的位置。第八章会把两者连接起来。
2. 启动前确认
确认基础模型、运行环境和已有工程都在;训练时接通电源,避免电脑自动睡眠,并为素材副本和多个检查点留出磁盘空间。原案例使用 RTX 4060 Ti 16GB,但训练曾接近显存上限,这不是对所有设置都能稳定运行的保证。
如果是在新机器上打开本文,只有 Markdown、图片和 LoRA 文件还不够。需要恢复运行环境、基础模型和对应程序;不要通过随意升级 Torch/CUDA 来猜测修复。
3. 双击启动文件
start.bat
会出现以下菜单。本菜单已对照本机启动文件核实,是文字转录,不是伪造截图。
1. Voice cloning Web UI
2. Command-line help
3. Dataset preparation and LoRA training
4. Official LoRA training Web UI
5. Exit
| 菜单项 | 用途 | 什么时候选 |
|---|---|---|
| 第一项 | 普通参考音频克隆界面 | 普通克隆实验;不能据此认定已加载 LoRA |
| 第二项 | 查看普通克隆程序的命令行帮助 | 查支持哪些参数 |
| 第三项 | 导入、切片、识别、复核、划分与 LoRA 训练 | 准备数据和训练新任务 |
| 第四项 | LoRA WebUI,同时包含训练和推理 | 使用已经训练好的 LoRA |
| 第五项 | 退出菜单 | 结束使用 |
要用已有 LoRA,输入:
4
然后按回车。看到后台实际输出本地服务地址,再打开浏览器:
http://127.0.0.1:7860
素材整理工具使用另一个端口:
http://127.0.0.1:7861
第一项和第四项都使用同一个推理端口,不要同时启动。黑色窗口是后台程序,使用过程中不要关闭;关闭浏览器标签页与关闭后台不是一回事。
4. Training 与 Inference 的区别
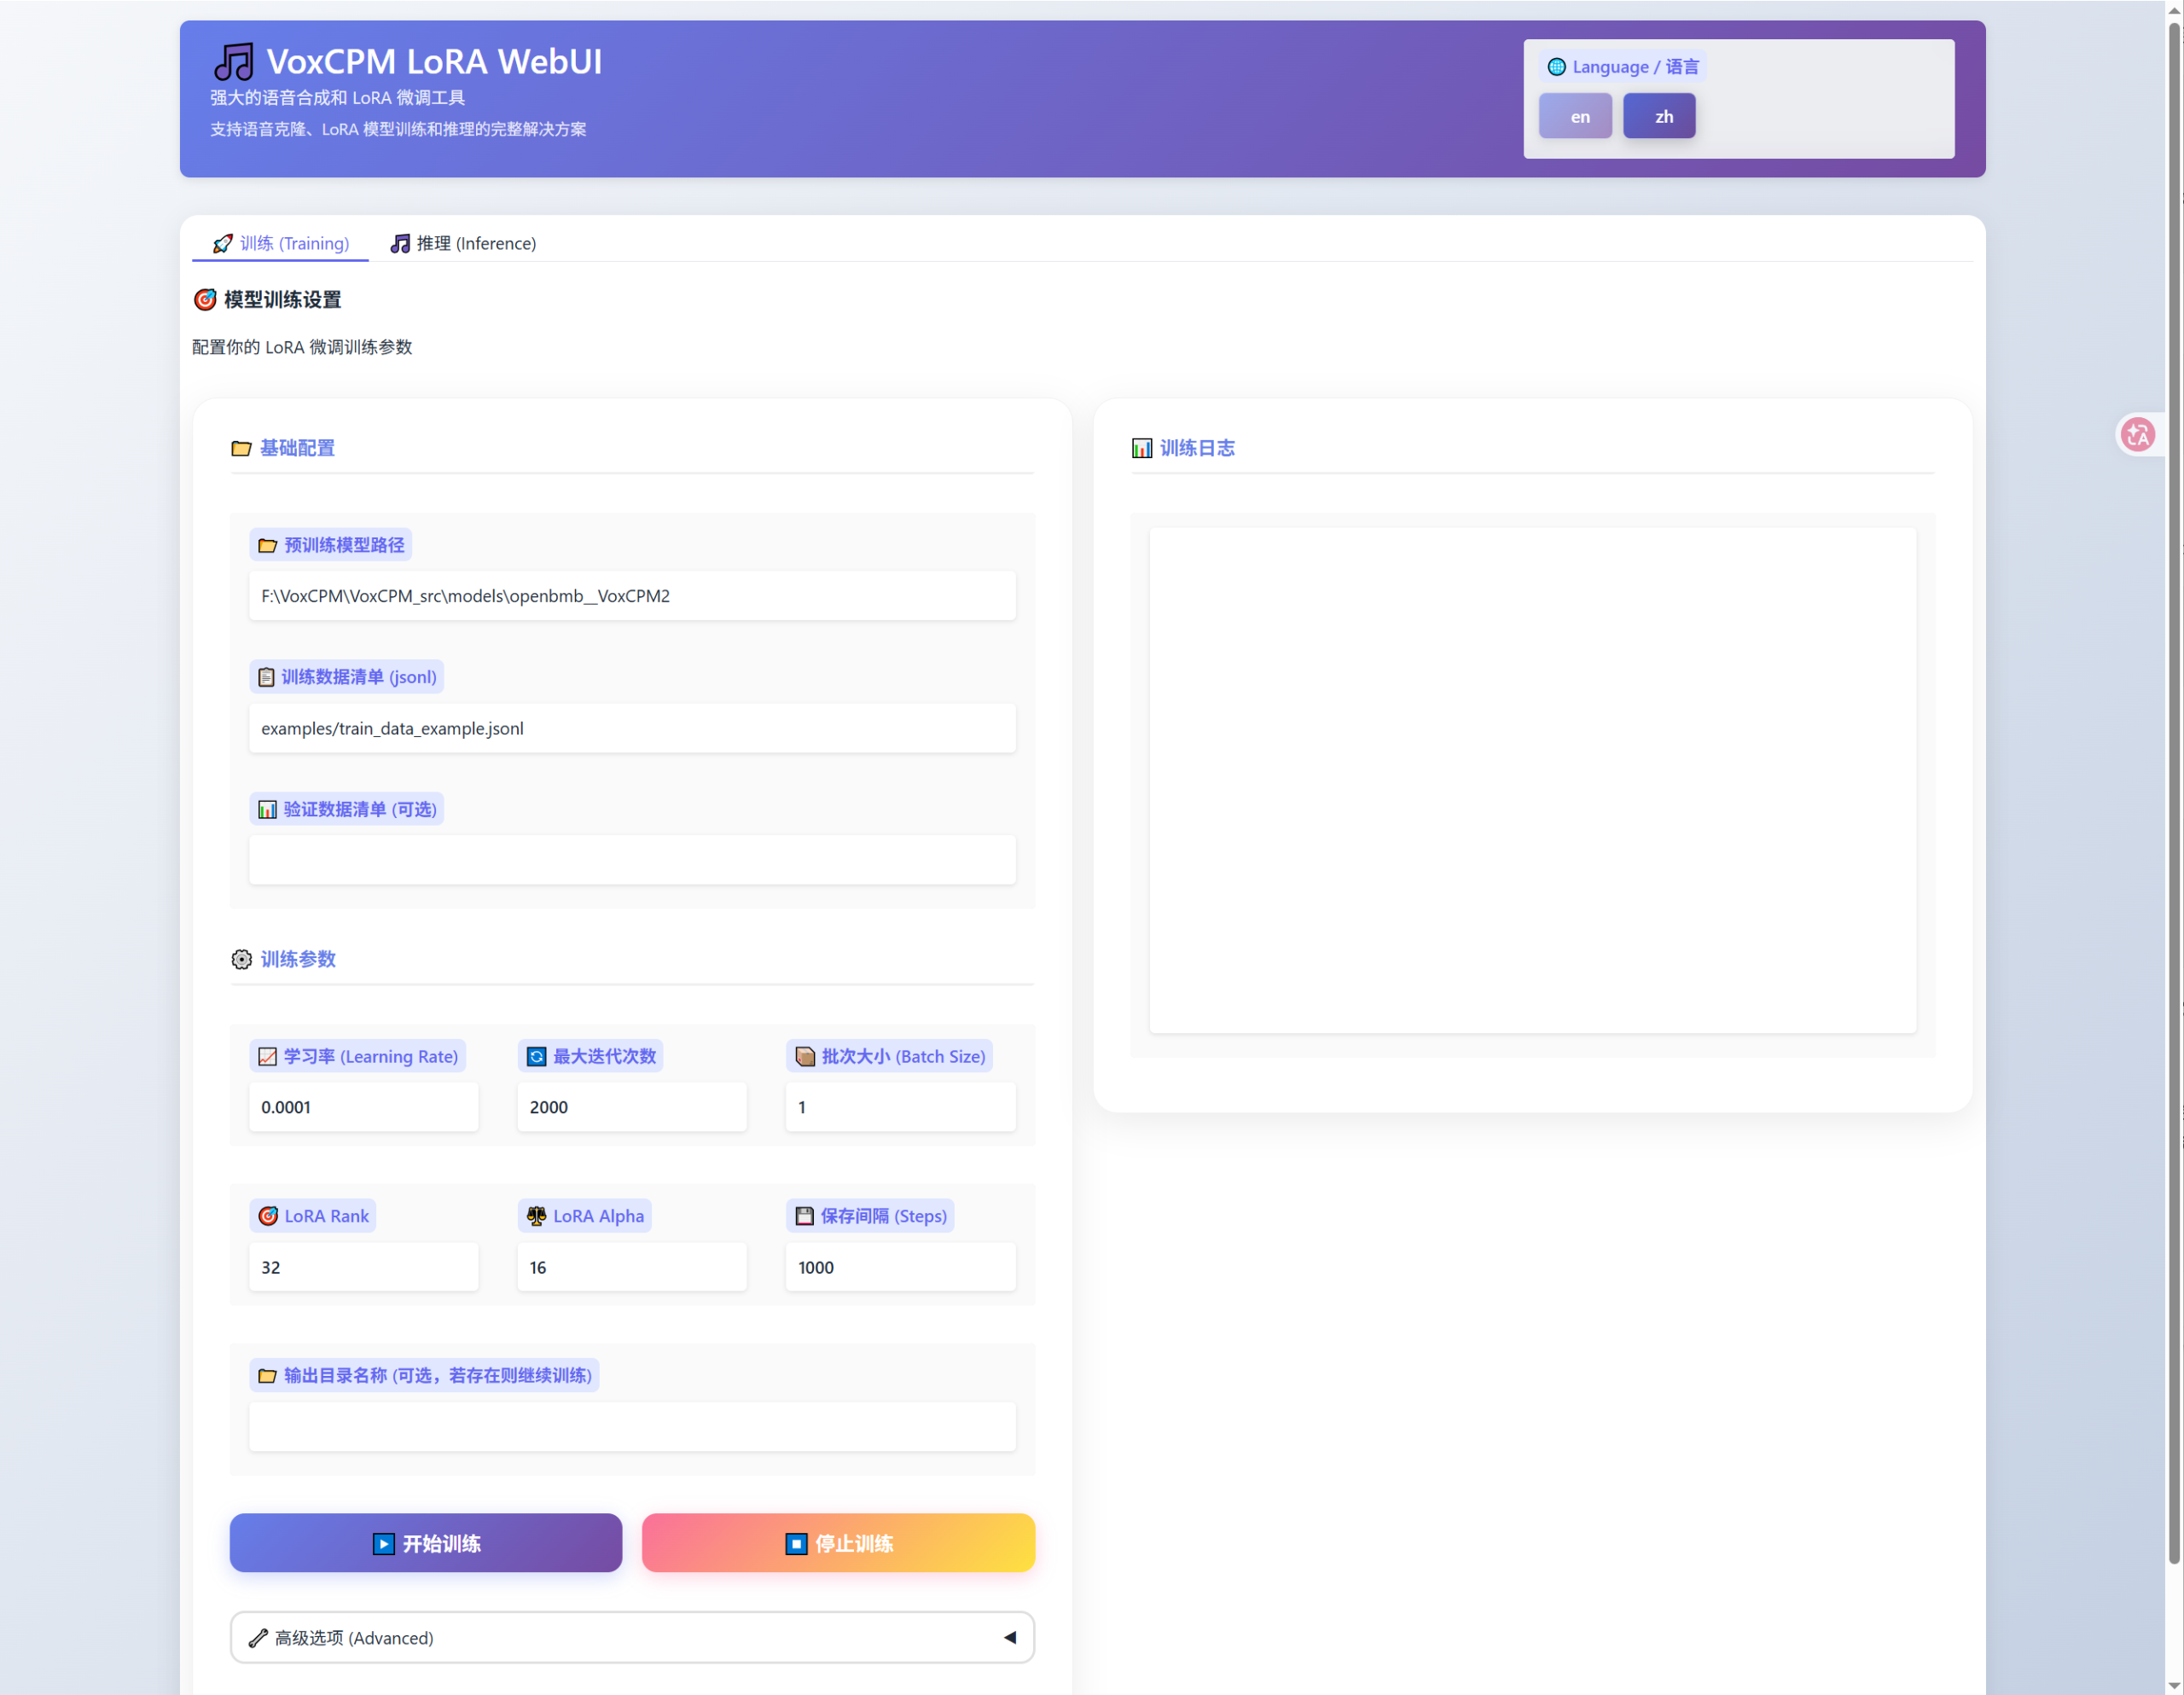
图1|Training 页面:创建训练任务,不是选择现有声音。
说明:这是用户原始截图。图中输入框展示的是当时页面值,并非已有模型的实际训练配置。本教程采用图下位置标注,保留截图原貌。
| 操作标注 | 图中位置 | 应当做什么 |
|---|---|---|
| 1-A | 左上方 Training 标签 | 训练新模型时才使用 |
| 1-B | Training 右侧 Inference 标签 | 仅使用已有声音时,点击这里 |
| 1-C | 左侧“预训练模型路径”与两种数据清单 | 真正训练前填写本机有效路径,不照抄截图示例 |
| 1-D | 左下方训练参数 | 对照第六章;截图里的迭代、Alpha 等值与旧任务不同 |
| 1-E | 左下方“开始训练” | 只是使用现有声音时不要点击 |
| 1-F | 右侧“训练日志” | 判断初始化、训练、验证、保存与错误状态 |
🌱 三、录音设备与场景测试
1. 先测试,再录长素材
原对话中用户明确更换了设备和场景,因此重新做了录音基准测试。不能把旧场景的合格结论直接沿用到新场景。记录中没有可靠确认具体麦克风品牌和型号,本文不虚构设备清单,也不要求为本流程购买新设备。
按以下顺序做:
- 找安静、回声较少的位置,避开持续风声、风扇直吹与其他人说话声。
- 固定录音设备、嘴与麦克风的位置、坐姿和输入增益。把实际位置记下来,方便下一次恢复。
- 尽量关闭美声、混响、变声、强降噪和自动音量增强;设备无法关闭的处理也应记录。
- 先录约一至两分钟,包含平静叙述、问句、稍有力度的感叹和数字。
- 戴耳机试听开头、中间、结尾;检查背景噪声、喷麦、失真和声音忽远忽近。
- 确实需要调整增益时,每次只调一点,再录二三十秒复测。合格后固定设置。
如果不熟悉英文,直接使用中文测试。不必因为原测试稿出现了英文而勉强朗读;后续正式语料已经按用户需求改为中文为主。
可直接朗读的短测试稿:
今天重新做一次声音测试。我会保持正常坐姿,用平时和别人聊天的声音说话。现在房间比较安静,我先说几句平静的话。
准备好了吗?准备好了,可以开始。怎么回事,刚才不是还好好的吗?真的?太好了,终于等到了!
有些事情不用着急,先把问题弄清楚,再一步一步处理。今天是九月二日,上午七点二十三分。价格是三百六十八元,距离十二点五公里,已经完成百分之六十八点五。
现在我把声音恢复到平常的状态。这一次测试结束了。
2. 怎样判断“够不够好”
| 检查项 | 可继续录的表现 | 应调整的表现 |
|---|---|---|
| 清晰度 | 说话清楚,自然 | 含糊、明显闷声或金属感 |
| 噪声与混响 | 安静段没有突出的持续噪声,尾音回声不明显 | 风声、机器声、空房间回声遮住人声 |
| 电平 | 正常讲话有余量,较激动的句子也不失真 | 爆红、平顶波形、爆裂音 |
| 一致性 | 前中后距离和音量基本稳定 | 越录越远、转头说话、忽大忽小 |
| 状态 | 像平时聊天 | 为了训练故意压嗓、播音腔、明显疲劳 |
录音电平的实用参考范围,而非硬性合格线:
正常说话峰值可参考:约 -12 ~ -6 dBFS
避免碰到数字满幅:0 dBFS
不要只为追求峰值而不断提高增益
峰值表示最响的一瞬间;整段 RMS 会受静音长度影响。数值较低不能单独证明录音不合格,数字达标也不能证明没有混响或喷麦。
原对话最终选用的测试文件和历史报告为:
Recording (9)
时长:约 28.7 秒
采样率:48 kHz
峰值:约 -12.8 dBFS
整段 RMS:约 -32.7 dBFS
证据说明:这些录音数值来自原对话当时的分析报告,本次制作教程没有重新测量、试听确认。它们是案例记录,不是每个人必须达到的指标。
🌱 四、设计并录制四组正式语料
1. 总量目标与最终安排
目标是四十至六十分钟的多样化、干净素材,不是拼命凑够一小时。原先曾讨论五组,实际在四组达到约五十分钟后决定收尾。本教程保留最终四组方案,去掉反复改计划的过程。
| 正式录音 | 原对话记录时长 | 主要用途 | 录法 |
|---|---|---|---|
| 第一组:自然叙述 | 约 10 分 05 秒 | 建立日常音色、自然长短句和基础节奏 | 像面对面讲一天的经历,不朗诵 |
| 第二组:日常对话与不同语气 | 约 11 分钟 | 覆盖提问、回答、确认、否定、感叹 | 对话可以由同一个人读,不模仿另一个角色的音色 |
| 第三组:数字、时间、日期与复杂中文表达 | 约 15 分 42 秒 | 补金额、数量、单位、百分比、方位和数字语境 | 按平时表达读,标注必须匹配实际读法 |
| 第四组:自然情绪与真实表达 | 约 13 分 04 秒 | 补高兴、期待、疑惑、着急、失望、严肃、安慰等状态 | 自然表达,不喊叫、不故意哭腔 |
四组原始录音合计约五十分钟。切掉口误、噪声和多余静音后,有效训练时长可能减少,这是正常现象。
2. 正式录音规则
- 每组录完休息五至十分钟,喝水,让嗓音恢复,再录下一组。
- 设备、场景、位置和增益保持一致。情绪变化通过语速、节奏、音高和语气表达。
- 读错时停一两秒,从该句重新读;后续切片时剔除错误版本,不必整组重来。
- 小节标题、情绪标签和操作说明不要读进素材。
- 保留原始文件。不先做强降噪、压缩、混响或反复转码。
- 每组试听前、中、后段,发现疲劳或环境变化,先休息或修复环境。
原录音为 M4A,也可以保留;已有文件改后缀不会变成 WAV,转 WAV 也不能恢复有损压缩丢失的信息。下一章的工具会生成用于处理的解码副本。
配套录音稿:四组正式录音稿(从原对话提取正文)。朗读速度不同会改变时长,不要为了追上表格时间而拖慢或重复读。对于稿子中的数字和金额,应以实际读音校对标注;它是录音语料,不是计算题答案。
🌱 五、把长录音整理成训练数据
1. 先备份已有素材工作区
本地素材工具使用固定工作目录。开始新一批数据前,先把旧工作区整体复制到独立备份位置,再操作;不要把新旧素材无意混在同一份清单里。
需要备份的旧工作区:
F:\VoxCPM\dataset

还应保留:原始录音、原稿、旧训练任务目录
已有训练清单引用本地音频路径,只保存清单而不保存切片,不能恢复数据集。
2. 打开素材整理页面
双击启动文件,在菜单中输入:
3
打开该工具的本地地址,然后按顶部六个标签顺序操作。下面按钮名称已对照本机源码核实;本次取回的四张截图未包含素材整理页面,因此这里采用文字步骤,不用其他软件截图冒充。
3. ① 导入音频
上传四组原始录音,或填写存放录音的文件夹路径,点击“导入并解码”。本工具生成单声道 WAV 副本,原始文件保留。
解码副本位置:F:\VoxCPM\dataset\wavs
工具解码格式:48 kHz,单声道 WAV
完成标志:导入结果显示成功;生成的副本能正常播放,没有空文件。
4. ② 自动切片
第一轮可以先用本机工具默认值,再试听判断是否要调整:
静音阈值:35 dB(本工具参数;不是录音峰值标准)
最短切片时长:3.0 秒
最长切片时长:12 秒
合并间隔:0.45 秒
点击“开始切片”。自动切片不是自动合格:重点检查首字是否被切掉、尾音是否完整、是否把两句话之间的口误带进来。不要为了达到某个切片总数而接受坏切片。
完成标志:有可播放的切片,并且边界大体合理。需要重新切片时,应在正式复核前处理,避免反复切片使已经校对的结果失效。
5. ③ 识别与原稿比对
把对应录音的正文粘贴到“原稿文本”,点击“开始识别”。本机工具使用 SenseVoice 做识别;首次加载较慢,若识别模型未准备好,应先解决模型加载问题。
原稿只帮助比对,自动识别不是最终答案。尤其注意数字、多音字、漏读、重复读和口误。
6. ④ 人工复核
逐条播放切片,检查“最终文本”。按实际听到的内容修正后,点击“通过并下一个”;坏片段点击“剔除”。
例如实际说的是“七点二十三分”,就不要标成“七点三十分”。如果读错一句又重读,优先保留正确版本;不能让音频保留错误读法,文字却假装完全正确。
完成标志:准备进入训练的每条切片都已复核,声音与文字对应。已复核总数、通过总数、有效导出总数是不同统计口径;若少了一条,应查状态、最终文本和划分结果,不要直接认定无影响。
7. ⑤ 划分与导出
原案例使用以下划分设置:
训练集比例:0.95
随机种子:42
先点“重新划分”,确认结果,再点“生成 JSONL”。训练集用于学习;验证集用来观察没有参与训练的样本表现。
训练清单:F:\VoxCPM\dataset\train.jsonl
验证清单:F:\VoxCPM\dataset\val.jsonl
原案例导出结果是六十八条、约九点九分钟,其中训练六十五条、验证三条。这个数字属于旧数据集,不是四组新录音应该得到的数量。原来的验证集很小,结论有限;新一轮应核对验证样本覆盖,并避免重复录音跨训练、验证集合造成误导。
JSONL 是“一行一个记录”的文本文件。本工具导出的字段如下,示例仅解释格式,不应直接复制覆盖真实清单:
{"text":"今天天气不错,我想出去走一走。","audio":"F:/VoxCPM/dataset/clips/clip_0001.wav","duration":4.8}
其中时长必须对应真实文件。通常直接使用页面导出结果,不需要手工编写。
🌱 六、进行 LoRA 训练
1. 推荐入口:素材整理工具的第六页
完成导出后,进入“⑥ LoRA 训练”。这个入口会复用本机的基础模型和官方训练脚本,输出到工程根目录下的 LoRA 文件夹。
已有任务的关键参数已从训练配置文件核实:
pretrained_path: F:/VoxCPM/pretrained_models/VoxCPM2
train_manifest: F:/VoxCPM/dataset/train.jsonl
val_manifest: F:/VoxCPM/dataset/val.jsonl
num_iters: 1000
max_steps: 1000
learning_rate: 0.0001
batch_size: 2
grad_accum_steps: 8
save_interval: 500
valid_interval: 500
warmup_steps: 100
num_workers: 4
sample_rate: 16000
out_sample_rate: 48000
lora:
  r: 32
  alpha: 32
  dropout: 0.0
  enable_lm: true
  enable_dit: true
  enable_proj: false
这是历史实际配置摘要,不是为所有显卡、数据量保证效果的通用最佳参数,也不是完整可直接运行的配置文件。完整旧配置仍保存在原任务目录;不要为了照抄教程改写它。
| 参数 | 简单解释 | 新手重点 |
|---|---|---|
| 迭代次数、最大步数 | 训练更新多少次 | 最后一步不一定最好,保存中间模型比较 |
| 学习率 | 每次更新参数的幅度 | 不凭感觉猛加 |
| Batch Size | 一次处理多少条样本 | 越大通常越占显存 |
| 梯度累积 | 累积多次计算再更新 | 旧案例有效批量为两者乘积 |
| Rank / Alpha | LoRA 容量和缩放配置 | 推理使用检查点自身配套配置 |
| 保存间隔 | 多久保存一次检查点 | 决定中断时和试听比较时可用哪些模型 |
| 验证间隔 | 多久评估验证数据 | 验证和试听会增加总耗时 |
2. 不要混淆三种采样率
原始录音或解码副本:48 kHz
本案例 VoxCPM2 AudioVAE 编码输入 sample_rate:16000
本案例输出 out_sample_rate:48000
原始录音是高采样率,不代表训练配置必须写同一个值。训练配置要匹配基础模型的编码器要求。本机模型配置与 官方 VoxCPM2 LoRA 配置 均区分编码输入和输出采样率。
3. 新任务怎么开始
确认数据清单有效,输入一个与旧任务不同的新名称,例如:
my_voice_v2
记录本次设置,点击“一键开始 LoRA 训练”,查看日志。本次应从适配的新数据任务开始,不要仅因同一个人的声音就覆盖旧任务。
如果显存不足,可在失败退出后降低单批数量,再评估梯度累积设置。例如以下只是保持名义有效批量的一种调整,不保证完全等价或解决所有显存问题:
原组合:batch_size = 2,grad_accum_steps = 8
可测试:batch_size = 1,grad_accum_steps = 16
长切片、其他占显存程序和模型状态也会影响显存。训练期间尽量不要同时运行其他大型 GPU 任务。
4. 备选入口:菜单第四项的 Training
如果使用图1的官方 LoRA Training 页面,需要手动填写基础模型和真实数据清单路径:
预训练模型路径:F:\VoxCPM\pretrained_models\VoxCPM2
训练数据清单:F:\VoxCPM\dataset\train.jsonl
验证数据清单:F:\VoxCPM\dataset\val.jsonl
截图中的示例清单、默认训练次数、Alpha 不能视为旧任务设置。当前启动方式还会让该页面的新训练输出位于源码目录内的 LoRA 文件夹,因此必须以本次日志实际保存路径为准。
对于零基础新手,优先使用已经走完数据整理流程的第六页;不建议在两个训练页面之间反复切换着启动同一任务。
5. 怎样看懂日志
| 日志内容 | 含义 | 是否代表完成 |
|---|---|---|
| 加载 AudioVAE、模型参数列表 | 初始化 | 否 |
| 大量参数后显示 False | 基础参数被冻结,不参与直接更新 | 否,也不等于错误 |
| CUDA、bfloat16 | 使用的设备与数值精度 | 只能说明初始化信息 |
| train step、loss | 已开始训练迭代 | 仍需等待后续保存 |
| val step | 验证 | 不一定是全部结束 |
| Generating sample、分数进度条 | 正在生成试听样本 | 不是主训练进度 |
| 返回码为零,且最终检查点已保存 | 程序正常结束并产生结果 | 可进入检查和试听 |
原对话中容易混淆的例子:
[train] step 860 ...
这是主训练步数;而下面这种是某条试听音频内部的进度:
29/142
Generating sample 1
不要看到试听进度百分比就重新计算主训练进度。训练最后可能先验证、生成样本,再保存最终模型;不要在这一阶段误点停止。
损失值上下波动不一定异常,学习率逐渐变小可能是正常调度。出现下列情况才需要进一步检查:
Traceback
CUDA out of memory
nan
inf
非零退出码
训练耗时应以最近多个主训练日志区间估算,并另加验证、试听和保存时间。旧案例耗时较长,不能把其小时数当作新一批数据或另一张显卡的承诺。
🌱 七、找到并检查模型
1. 直接打开已有最终检查点
F:\VoxCPM\lora\lora_20260822_211954\checkpoints\step_0001000
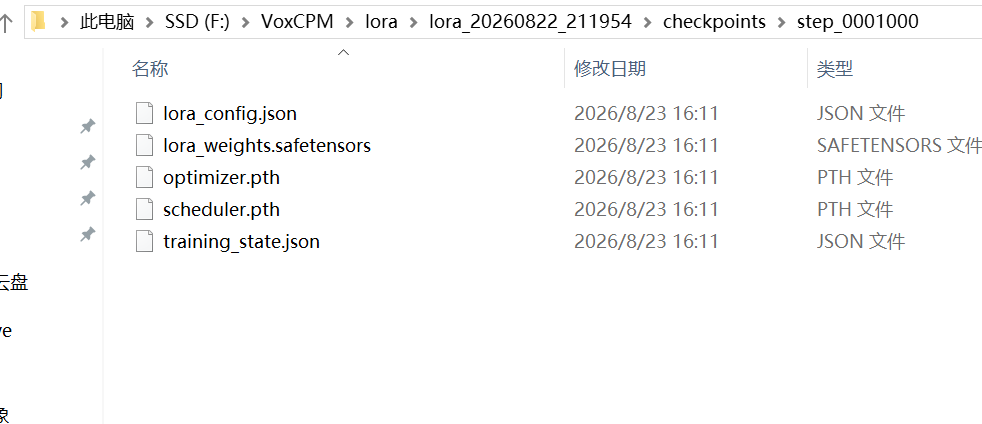
图2|最终检查点:核对任务名称、步数和配套文件。
说明:用户截图显示已有任务的最终目录和五个文件。文件存在是基础检查,并不能仅凭截图证明文件内容没有损坏或声音质量合格。
| 操作标注 | 图中位置 | 应当做什么 |
|---|---|---|
| 2-A | 顶部地址栏 | 核对是指定任务、指定检查点,而不是其他工程 |
| 2-B | 文件列表前两行 | 确认权重和配置都在同一目录 |
| 2-C | 文件列表后三行 | 保留训练状态文件,便于完整归档和可能的续训 |
2. 五个文件各做什么
1. lora_config.json
2. lora_weights.safetensors
3. optimizer.pth
4. scheduler.pth
5. training_state.json
| 编号 | 作用 | 使用建议 |
|---|---|---|
| 1 | 记录基础模型、LoRA 结构和缩放等配置 | 与同一检查点的权重配套;不要拿别的任务配置替换 |
| 2 | 实际训练得到的适配器权重 | 推理核心文件;还需要匹配的基础模型 |
| 3 | 优化器状态 | 通常供断点续训,不是普通推理的必要输入 |
| 4 | 学习率调度器状态 | 通常供断点续训,建议保留 |
| 5 | 训练步数等状态 | 帮助检查进度;续训仍取决于程序是否支持正确恢复 |
本次只读核对,状态文件记录为:
{"step": 1000}
上一级通常还会看到:
checkpoints
├─ step_0000000
├─ step_0000500
├─ step_0000999
├─ step_0001000
└─ latest
中间检查点便于比较;最新检查点不等于最佳检查点。不要只凭名称认定最新目录与某一步完全相同,需要时核对状态或文件哈希。
完整备份应保留整个任务目录,包括配置与日志;不要只挑一个权重文件保存后就删除其余内容。
🌱 八、解决推理页面看不到 LoRA
1. 典型现象
图3|Inference 页面:先确认模型选择,再填写生成内容。
说明:用户截图显示推理页面已打开,但模型下拉框仍未选中 LoRA。这里的截图是当时状态,不是本次制作教程时重新运行的结果。
| 操作标注 | 图中位置 | 应当做什么 |
|---|---|---|
| 3-A | 顶部 Inference 标签 | 确认进入推理页 |
| 3-B | 中间列上方 LoRA 下拉框 | 打开列表,查看是否存在目标检查点 |
| 3-C | 下拉框下方“刷新模型列表” | 文件放好后点击它,再重新展开下拉框 |
| 3-D | 左列“合成文本” | 填要生成的新句子 |
| 3-E | 左列下半部参考音频、参考文本 | 填示范录音及其实际原文 |
| 3-F | 中列 CFG、推理步数、随机种子 | 第一轮按第九章固定设置 |
| 3-G | 中列底部“生成音频” | 选好模型后再生成 |
| 3-H | 右列音频与状态信息 | 确认生成是否成功,并试听、保存 |
None = 未启用 LoRA,使用基础模型
没有选中模型和列表扫描不到模型是两种情况。先刷新、展开列表确认;只有仍找不到目标任务时才进入目录排查。
2. 根因:启动位置决定相对扫描目录
当前启动菜单第四项先进入源码目录,再运行 LoRA WebUI。扫描函数使用相对目录,因此实际查找的是:
启动后的工作目录:F:\VoxCPM\VoxCPM_src
相对扫描目录:lora
实际扫描目录:F:\VoxCPM\VoxCPM_src\lora
但素材整理工具此前把模型保存到了:
F:\VoxCPM\lora
模型没有丢,只是两处路径不同。本机启动文件和扫描代码已核对这一行为。
3. 可复现排障步骤:检查、复制整个任务、刷新
第一步:检查原模型。 在资源管理器打开第七章的最终检查点,确认配套文件存在。原路径不可用时先查真实训练输出,不要创建几个同名空文件冒充模型。
第二步:检查 WebUI 扫描位置。
F:\VoxCPM\VoxCPM_src\lora
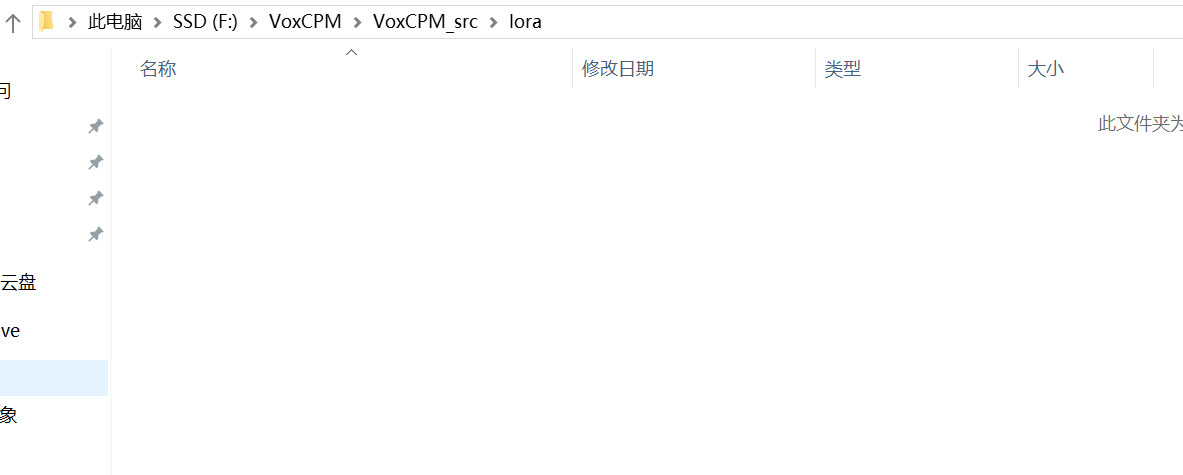
图4|历史空目录:解释“模型在磁盘上,但页面看不到”。
说明:这是原对话用户提供的历史截图。它证明当时该位置为空,不代表今天依然为空。
| 操作标注 | 图中位置 | 应当做什么 |
|---|---|---|
| 4-A | 顶部地址栏 | 确认经过了源码文件夹,再进入 LoRA 文件夹 |
| 4-B | 下方空白文件列表 | 这里为空,而原训练目录有模型时,继续复制步骤 |
第三步:复制整个训练任务文件夹。 回到下面的原目录:
F:\VoxCPM\lora
选中以下整个文件夹,右键“复制”:
lora_20260822_211954
然后进入目标目录,右键“粘贴”:
F:\VoxCPM\VoxCPM_src\lora
复制,不是剪切。保留原训练输出。 不要只复制单个权重文件,也不要把整个任务再套进同名任务文件夹,导致多嵌套一层。
最终检查点应该位于:
F:\VoxCPM\VoxCPM_src\lora\lora_20260822_211954\checkpoints\step_0001000
对应结构:
F:\VoxCPM\VoxCPM_src\lora
└─ lora_20260822_211954
   ├─ train_config.yaml
   ├─ logs
   └─ checkpoints
      ├─ step_0000500
      ├─ step_0000999
      ├─ step_0001000
      │  ├─ lora_config.json
      │  ├─ lora_weights.safetensors
      │  ├─ optimizer.pth
      │  ├─ scheduler.pth
      │  └─ training_state.json
      └─ latest
第四步:刷新模型列表。 回到图3,点击标注 3-C 的按钮,打开 3-B 下拉框,选择:
lora_20260822_211954\checkpoints\step_0001000
部分显示可能附带基础模型名称。重点是任务名称与检查点正确。
第五步:短句生成验收。 列表出现只证明找到了文件;还要成功加载、生成并试听,才算推理流程通过。
4. 目标已经有同名文件夹时
不要直接覆盖,也不要反复复制。先检查现有副本的目录层级、权重与配置;必要时使用下面的只读 PowerShell 命令比较两个核心文件:
$sourceCheckpoint = 'F:\VoxCPM\lora\lora_20260822_211954\checkpoints\step_0001000'
$targetCheckpoint = 'F:\VoxCPM\VoxCPM_src\lora\lora_20260822_211954\checkpoints\step_0001000'
'lora_config.json','lora_weights.safetensors' | ForEach-Object {
    Get-FileHash -LiteralPath (Join-Path $sourceCheckpoint $_)
    Get-FileHash -LiteralPath (Join-Path $targetCheckpoint $_)
}
对应文件的哈希相同,说明对应内容一致;若不同,先保留两份并确认哪个任务版本正确。
2026-09-05 本次核对结果:目标目录已经存在该任务,原目录与目标目录中的上述两个核心文件 SHA-256 一致。本次只做读取和比较,没有替用户再次复制、改启动器或重新推理。
5. 可探索的长期方案
长期可以统一启动工作目录,或让代码始终使用明确的绝对模型目录,从而减少两份副本的维护。那属于程序维护,不是新手照着本教程必须做的动作。
本教程推荐当前菜单配合完整复制的办法来复现本次排障;不建议为了修复下拉框而重新训练、重装环境或把模型放进其他软件的普通 LoRA 目录。以后新训练出的模型不会自动同步到副本,要核对本轮输出和扫描位置。
🌱 九、第一次推理与效果对比
1. 先做最简单的连通测试
启动菜单第四项,进入 Inference,刷新并选择目标检查点。先只验证已有 LoRA 能正常使用:
LoRA:lora_20260822_211954\checkpoints\step_0001000
合成文本:今天天气不错,我想出去走一走。
参考音频:不上传
参考文本:留空
CFG Scale:2.0
推理步数:10
随机种子:42
原截图种子是随机值;这里固定种子是为了方便后面的对比。固定种子有助于同一环境对照,不保证跨硬件、跨版本逐字节一致。
点击“生成音频”。第一次可能需要加载基础模型和 LoRA。查看状态信息,播放结果,确认没有漏字、重复、异常噪声或音色明显不对。
Generation Success
状态成功与音频可以播放代表流程跑通;“像不像本人、自然不自然”还需要实际试听。生成后使用音频组件的下载功能保存,不要只依赖网页临时输出。
2. 加入中立参考音频
第一轮可用后,保留同一模型、同一句合成文本和参数,上传自己的中立录音:
参考音频:中立.wav
参考文本:这段录音里实际说出的全部文字
合成文本是想让模型新说的话;参考文本是上传录音原本说的话。两者不是同一个框,也不要求内容相同。
本机界面支持参考文本留空时自动识别,但首次稳定测试建议手动填写准确原文;自动识别失败时先补文本,不必重训 LoRA。
3. 感觉“差点意思”时怎样调
保持文本和参考音频不变,每次只调整一个变量。可按这个顺序测试:
A:step_0001000 / CFG 2.0 / steps 10 / seed 42
B:step_0001000 / CFG 2.0 / steps 20 / seed 42
C:step_0001000 / CFG 2.5 / steps 20 / seed 42
D:step_0000500 / CFG 2.5 / steps 20 / seed 42
比较时四组全部使用同一段参考音频,或者全部不使用,不要中途悄悄更换条件。
| 试听维度 | 检查问题 |
|---|---|
| 相似度 | 是否接近自己的声音 |
| 清晰度 | 字是否读全,有无含糊或错音 |
| 自然度 | 节奏是否僵硬,停顿是否奇怪 |
| 稳定性 | 是否重复、漏字、突然变声或尾部异常 |
推理步数增加通常会增加耗时,但不保证质量按比例提高;CFG 更大也不是一定更好。旧数据较少,最终模型可能不如中间检查点自然,但不能只凭“数据少、步数多”直接断定过拟合。
先比较推理设置和检查点,再决定是否重新整理数据、重新训练。不要一次改模型、参考音频、文本和所有参数,否则不知道改善来自哪里。
4. 长文怎样处理
先用短句验证,再逐渐测试自然段。长文章建议按句子或段落分段生成、逐段试听后再拼接;本文没有交付自动长文工作流,也不保证截图界面自带自动切段。没有一个适合所有文本和机器的“最长分钟数”。
🌱 十、建立情绪参考音频库
1. 为什么另录短参考
四组正式语料用于训练;短参考库用于生成时随时切换示范状态。可以从质量好的真人长录音中选取完整片段,也可以专门录制,优先使用同一个人的真实录音。
建议先准备五种:中立、高兴、惊喜、伤心、愤怒。有实际需求时,再补温柔、严肃、着急,不必为了数量一次做很多。
每条建议:约 8~12 秒
内容:完整的一两句或几句自然表达
录法:同一设备、固定距离、无音乐、无明显噪声与混响
配套:每条保存准确逐字文本
这是本案例的参考库设计建议,不是模型的强制时长限制。较短片段也可能可用,最终以试听结果为准。避免“愤怒就喊、伤心就把音量压到听不清”。
2. 原五段参考的历史反馈
以下数值来自原对话,未在本次重新测量:
高兴.wav:约 3.1 秒,峰值约 -9.7 dBFS
惊喜.wav:约 4.2 秒,峰值约 -5.8 dBFS
伤心.wav:约 4.5 秒,峰值约 -27.8 dBFS
中立.wav:约 3.2 秒,峰值约 -11.9 dBFS
愤怒.wav:约 3.4 秒,峰值约 -1.2 dBFS
| 原参考 | 当时建议 | 正式参考库如何处理 |
|---|---|---|
| 中立、高兴 | 状态可保留,内容较短 | 录得完整一点,作为稳定基准 |
| 惊喜 | 表达较明确 | 可保留比较,再补更完整版本 |
| 伤心 | 声音明显偏小 | 正常音量重录,以慢节奏和语气表达 |
| 愤怒 | 峰值接近满幅 | 不喊叫,用咬字和语气体现力度 |
接近满幅不等于已经削波;峰值偏小也不自动等于不可用。这里建议重录的目标,是减少不同参考之间过大的音量差和录法差异。
3. 可直接录制的示范台词
下面是本教程补充的参考稿,不是声称已经录好或验证过的音频。自然读完后看实际时长,太短就补一句完整表达,不要用静音凑秒数。
| 状态 | 台词 | 录法 |
|---|---|---|
| 中立 | 今天没有特别着急的安排。我准备先把手里的事情做完,再出去走一走。你不用等我,我处理好了就告诉你。 | 正常聊天,平稳自然 |
| 高兴 | 太好了,这件事终于做成了。我刚才又检查了一遍,确实没有问题。今天总算可以轻松一点,我们一起庆祝一下吧。 | 有笑意,不提高增益 |
| 惊喜 | 真的已经准备好了吗?我还以为要等到明天。你让我看一下,还真是这样,这个消息确实让我有点意外。 | 自然抬高语调,不尖叫 |
| 伤心 | 我原本以为今天能见到你,没想到计划又变了。现在确实有一点失落,不过没关系,等你方便的时候我们再约。 | 稍慢、低落,但说清楚 |
| 愤怒 | 这件事我们之前已经说清楚了,你为什么又这样处理?我现在确实有点生气,希望你认真解释一下,不要再敷衍过去。 | 坚定、有力度,不吼 |
| 温柔 | 没关系,你先慢慢说,我在这里听着。不用一下子把所有事情都解决,我们先把最难的部分一起想清楚。 | 柔和,不故意气声化 |
| 严肃 | 这一步需要重新检查。结果没有确认之前,请先不要继续操作。我们把原因查清楚,再决定接下来怎么处理。 | 稳定、有明确停顿 |
| 着急 | 时间快到了,我们得先把重要的东西带上。你看看手机和钥匙有没有拿好,我在门口等你,准备好了就出发。 | 稍快,仍保持清楚 |
保存名称示例:
参考音频库
├─ 中立.wav
├─ 中立.txt
├─ 高兴.wav
├─ 高兴.txt
└─ ……
文本文件写实际录制结果,不是未经校对的台词。换参考时比较相同合成文本的结果;参考主要提供示范,不保证精确复制情绪强度。不建议把模型生成的失真音频反复用作参考库基准。
🌱 十一、常见问题与排错表
| 现象 | 可能原因 | 优先检查和处理 | 怎样算解决 |
|---|---|---|---|
| 浏览器拒绝连接 | 后台未就绪、已退出或地址不对 | 看黑窗口最新日志,等实际服务地址;核对端口 | 正确页面能打开 |
| 普通克隆页没有 LoRA 选择 | 选了菜单第一项 | 结束对应后台,改用第四项的 Inference | 能看到 LoRA 下拉框 |
| 下拉框只有 None | 扫描位置与保存位置不同,或尚未刷新 | 按第八章核对两处目录,必要时复制整个任务 | 目标检查点可选 |
| 目标目录已经有模型 | 之前已经复制过 | 核对层级与文件,不直接覆盖 | 哈希一致后刷新、短句测试 |
| 模型可选但加载失败 | 基础模型路径无效、配套配置不匹配、文件损坏 | 看状态与后台报错,核对配置中的基础模型和核心文件 | 日志加载成功且能生成 |
| 参考音频自动识别失败 | 识别模型不可用或参考内容无法识别 | 手动填写准确参考文本,再试 | 正常生成 |
| 合成念的是参考文本 | 两个文本框混淆或生成异常 | 分清新文本与参考原文,用短句复测 | 输出新文本内容 |
| 显存不足 | 批量、切片长度、并行 GPU 程序等 | 关闭其他占显存任务;退出后评估降低批量 | 新测试无显存报错 |
| 训练显示 False | 基础参数被冻结 | 查看后续训练日志 | 正常出现主训练步数 |
| 进度似乎退回百分之几 | 正在生成试听样本 | 区分主训练日志和样本进度 | 主训练或最终保存继续 |
| Loss 偶尔上升 | 样本差异造成波动,也可能需要进一步检查 | 看较长趋势、验证和实际试听 | 不发散,试听可接受 |
| 训练到最后还没退出 | 仍在验证、试听或写文件 | 查看最新日志,等待最终保存 | 正常退出并有完整检查点 |
| 录音太小 | 增益偏低、距离变化等 | 先试听;必要时小幅调增益后复录测试 | 清楚、无失真、噪声可接受 |
| 喷麦、爆裂音 | 气流冲击或削波 | 调整相对位置、降低过高增益再录 | 测试无爆裂和削波 |
| 声音像但僵硬 | 数据、训练深度、参考或推理设置影响 | 固定条件比较中间和最终检查点 | 以清晰和自然度选版本 |
| 生成长文重复或漏字 | 单次文本过长或生成不稳定 | 拆成自然段,逐段检查 | 每段完整正确后再拼接 |
| JSONL 存在却找不到音频 | 只搬清单、切片路径失效 | 保留切片目录并核对清单路径 | 清单中的音频均可读取 |
| 页面对不上教程 | 工程或版本不同 | 先核对目录、启动入口和源码 | 找到对应功能后再操作 |
端口占用报错示例:
OSError: Cannot find empty port in range: 7860-7860
先确认是否已打开另一个 VoxCPM 服务;只结束自己明确识别的那个旧服务,不要盲目结束全部 Python 进程。
🌱 十二、保存、迁移与完成检查
1. 新人最容易忽略的事项
- 使用自己或已获授权的录音,保留原始素材。
- 先做短测试再录长稿;读错一句重读该句即可。
- 原始录音、处理后的切片和短参考分开管理。
- 数据文字必须匹配实际声音,不是匹配“本来想读的稿子”。
- 不把 IndexTTS、图像模型或其他架构的 LoRA 混进 VoxCPM2。
- 模型权重与配置成套保存,基础模型也要保留。
- 不把“文件存在”“列表出现”“生成成功”“听起来满意”当成同一级别的结论。
- 新训练使用新任务名称,不覆盖唯一的可用版本。
- 不把截图默认值当作历史训练配置或通用最佳参数。
2. 三个阶段的完成检查
素材完成:
- ☐ 固定设备、场景和录法,通过短测试。
- ☐ 四组录音内容各有用途,原始文件与稿子已保存。
- ☐ 所有保留切片已试听,文字逐条校对。
- ☐ 已导出清单,切片文件能读取,导出数量已核对。
训练完成:
- ☐ 日志正常结束,没有把样本生成误认为总进度。
- ☐ 最终检查点包含权重与配套配置。
- ☐ 整个任务目录已备份,保留至少一个中间检查点比较。
推理完成:
- ☐ 从第四项进入 Inference,目标 LoRA 可选。
- ☐ 短句生成成功,输出可播放且已保存。
- ☐ 中立参考与原文准确,试听没有明显漏字、重复、变声。
- ☐ 已记录选用的检查点、参考、文本、CFG、步数和种子。
3. 保存与迁移声音工程
迁移声音工程时,应另行备份基础模型、完整训练任务、数据与所用环境,并重新核对机器路径。本文是使用教程,不是可直接启动的软件安装包。四组正式录音稿见文末附录。
🌱 十三、资料来源与证据边界
- 「声音克隆」原对话:读取至可用历史起点,整理录音设计、训练记录、路径排障与用户截图。删除重复试错、其他工程操作及已被后续事实纠正的建议。
- 本机只读核对:启动菜单、素材工具六页功能、JSONL 导出格式、相对路径扫描逻辑、推理参数默认值、参考文本自动识别逻辑。
- 已有模型只读核对:实际训练配置、LoRA 配置、训练状态;两处最终检查点的权重和配置内容一致。
- 版本补充核对:官方 VoxCPM2 LoRA 配置,用于确认采样率区分;页面与本地版本不同时,以对应版本实际代码和模型配置为准。
本次可取回并查看的用户相关图片共四张,已全部收录为图1至图4,采用原图加图下位置操作标注。其他历史图片在读取记录中仅有占位,未用重绘或其他来源图片冒充。
整理本文时没有重新训练、测量历史录音或重新生成语音。因此本文明确区分:原对话当时的结果、本次文件和代码核对、供新一轮使用的操作建议。四组新语料是否已完成新的 VoxCPM2 训练,以及当前页面最终试听是否满意,均不能由这份教程制作过程直接证明。
🌱 附录:四组正式录音稿
本文件从「声音克隆」原对话提取四组录音正文,去掉正文前后的临时对话和下一步提示。保留正文原有措辞及段落,未重新创作成另一套稿子。原稿里仍有少量字母,例如停车区编号;不会读时可自然说“甲区、乙区、丙区”,后续按实际录音标注,不必勉强。
只读正文,不读标题、编号、分隔线或本说明。 每组录完休息五至十分钟。读错一句停一下重新读,后续剔除错误片段。不要改变录音位置和增益。稿子中的计算与日期是语言素材;如自行修正文案,保留实际使用的稿子,最终标注以真实读音为准。
原对话四组实际录音合计约五十分钟;具体时长随语速而变,不用静音或重复朗读凑时间。
🌱 第一组|自然叙述
今天是一个很普通的日子。早上醒来的时候,我没有马上起床,而是在床上躺了一会儿。窗帘没有完全拉开,外面的光从缝隙里照进来,房间慢慢亮了起来。
我拿起手机看了一眼时间,发现比平时稍微晚了一点。不过今天没有特别着急的事情,所以也就没有催着自己马上起来。
洗漱之后,我给自己倒了一杯水,在桌边坐了一会儿。早上的这段时间通常比较安静,没有太多电话,也没有太多消息。很多事情反而可以在这个时候慢慢想清楚。
有时候我觉得,一个人的一天其实是从很多小事情开始的。打开窗户,整理桌面,喝一杯水,看一眼今天要做的事情。这些事情看起来没有什么特别,但它们会一点一点影响一天的状态。
今天我要处理的事情不少。有些比较重要,需要认真完成;有些只是顺手处理一下就可以。我习惯先把事情简单排一下顺序,看看哪些必须今天完成,哪些可以稍微往后放一放。
当然,计划并不一定总能按照原来的安排进行。
上午十点多的时候,我正在处理手头的事情,手机突然响了。原本以为只是一个普通电话,没想到对方告诉我,之前一直在等的事情终于有结果了。
听到这个消息,我第一反应是:“这么快吗?”
对方笑了一下,说:“其实也不算快,我们已经准备很长时间了。”
想想也是。有些事情在等待的时候,总觉得时间过得特别慢。等真正有结果以后,再回头看,好像也没有过去多久。
挂掉电话以后,我重新坐下来,把刚才做到一半的事情继续完成。
窗外偶尔能听到汽车经过的声音。楼下有人说话,还有一阵很轻的风吹过树叶。天气没有特别热,也没有特别冷,是一个让人觉得比较舒服的温度。
到了中午,我突然发现自己有点饿了。
“今天吃什么呢?”
这个问题看起来简单,但有时候还真不知道怎么回答。
打开冰箱看了一会儿,里面有鸡蛋、青菜、一些水果,还有昨天剩下的一点东西。我想了想,最后还是决定简单一点,不折腾了。
吃饭的时候,我没有看手机。
以前总觉得吃饭的时候顺便看看消息、看看视频,可以节省一点时间。后来才发现,真正安静地吃完一顿饭,其实也挺舒服。
很多时候,我们总想着同时做几件事情。
一边吃饭,一边看手机;一边走路,一边回复消息;一边听别人讲话,一边想着下一件事情。
看起来效率很高,但脑子好像从来没有真正停下来过。
下午,我出去走了一会儿。
路上的人不算多。经过一个路口的时候,我看到一个小孩子拉着爸爸的手,站在那里等红灯。
孩子一直在问:“什么时候可以走?”
爸爸说:“等绿灯亮了就可以。”
过了一会儿,孩子又问:“现在呢?”
爸爸还是回答:“再等一下。”
我从他们旁边走过去的时候,忍不住笑了一下。
小时候总觉得很多事情应该马上发生。想吃什么,就希望马上能吃到;想去哪里,就希望马上能出发。
长大以后才慢慢明白,有些事情确实需要等。
不是所有问题今天都必须得到答案,也不是所有事情努力以后马上就会有结果。
走到前面的商店,我买了一瓶水。
老板问我:“还需要别的吗?”
我说:“不用了,就这个,谢谢。”
从商店出来以后,我没有马上回去,而是继续往前走了一段。
太阳已经不像中午那么亮了,路边建筑的影子慢慢变长。远处有人骑着自行车经过,还有一辆公交车停在站台旁边。
我忽然想到,其实我们每天都会经过很多这样的场景。
只是大部分时候走得太快,没有认真注意。
如果稍微慢一点,就会发现生活里有很多声音。
汽车启动的声音,关门的声音,风吹树叶的声音,远处有人叫名字的声音,还有鞋子踩在地面上的声音。
这些声音平时并不会引起注意,可当周围真正安静下来的时候,它们反而会变得非常清楚。
回去以后,我重新打开电脑。
桌面上还有几个没有处理完的文件。我看了一遍,决定先把最麻烦的那个解决掉。
刚开始的时候确实有点困难。
试了第一种方法,没有成功。
换了第二种方法,还是不太对。
我停下来想了一会儿,又重新检查了一遍前面的步骤。
后来才发现,问题其实出在一个很小的地方。
改完以后,再运行一次。
这次成功了。
那一瞬间确实会觉得很舒服。
并不是因为解决了多大的问题,而是因为一个困扰了自己一段时间的事情,终于有了明确的答案。
很多事情其实都是这样。
没找到原因之前,会觉得特别复杂;真正找到问题以后,又会觉得:“原来就是这里。”
所以遇到问题的时候,我现在越来越愿意先把事情弄清楚。
哪里正常,哪里不正常;刚才做过什么;改变了什么;问题从什么时候开始出现。
一点一点往前找,通常比不停地重新尝试有效得多。
傍晚的时候,天慢慢暗下来。
房间里的光线也发生了变化。我把灯打开,坐回原来的位置。
一天到了这个时候,人的状态和早上已经不太一样。
早晨更容易想着:“今天我要完成什么?”
到了晚上,更多时候会想:“今天到底做了些什么?”
有些事情完成了,有些没有。
以前我会比较在意那些没有完成的事情。现在反而觉得,只要真正解决了几个重要问题,这一天就不算浪费。
毕竟时间不是一张必须全部填满的表格。
有时候快一点,有时候慢一点,都很正常。
重要的是,当自己决定做一件事情的时候,能够真正把注意力放进去。
晚上吃过饭以后,我把桌面简单收拾了一下。
有些东西放回原来的位置,有些文件重新整理,有些暂时用不到的东西就先收起来。
一个干净一点的桌面,会让我觉得脑子也清楚一点。
当然,这只是我自己的习惯。
有人喜欢桌面上什么都没有,有人喜欢把常用的东西全部放在手边。其实没有哪一种一定更好,只要自己用起来舒服就行。
我一直觉得,很多事情没有所谓唯一正确的方法。
别人觉得好的方法,不一定适合自己。
同样,一个现在很好用的方法,过一段时间以后,也可能需要改变。
人的习惯会变,环境会变,需要解决的问题也会变。
所以比找到一个完美的方法更重要的,是知道什么时候应该继续,什么时候应该调整。
今天差不多也是这样。
没有发生什么特别大的事情,但一天还是慢慢过去了。
现在回头想想,早上的阳光,中午的一顿饭,下午走过的那条路,还有刚刚解决掉的那个问题,好像都很普通。
可真正的生活,大概就是由这些普通的事情组成的。
不一定每天都有值得记住的大事,也不一定每天都必须发生改变。
有时候能够安安静静地完成自己的事情,和喜欢的人说几句话,吃一顿舒服的饭,晚上回来的时候觉得今天还不错,就已经很好。
明天会发生什么,现在还不知道。
也许计划会改变,也许会突然出现新的事情,也许一切和平时没有什么不同。
没关系。
等明天真正到来的时候,再去处理明天的问题。
今天,就先到这里。
🌱 第二组|日常对话与自然语气
早上刚坐下来,手机就响了。
“喂,你好。”
“你好,现在说话方便吗?”
“方便,你说吧。”
“昨天发给你的东西看了吗?”
“看了一部分,还没有全部看完。”
“感觉怎么样?”
“整体没什么问题,不过有几个地方我还想再确认一下。”
“哪里需要调整?”
“别着急,我整理好以后一起发给你。”
“行,那我等你消息。”
“好的,没问题。”
挂掉电话以后,我突然想起来,还有一件事情忘了问。
算了,等一会儿再说吧。
没过多久,对方又发来一条消息。
“对了,还有个问题。”
我看到以后笑了一下。
看来我们想到一起去了。
我回复:“正好,我刚才也想问你一件事情。”
有些时候,沟通就是这样。
电话已经挂了,才突然想起最重要的那句话没有说。
中午的时候,有人问我:
“你吃饭了吗?”
“还没有。”
“都这个时间了,怎么还没吃?”
“刚才有点事情,忙完就忘了。”
“那你准备吃什么?”
“不知道,还没想好。”
“要不要一起出去吃?”
“去哪儿?”
“附近随便找一家。”
“现在吗?”
“对啊,不然还等到晚上?”
我看了一眼时间。
“行吧,等我五分钟。”
“五分钟?你确定?”
“确定,很快。”
结果十分钟以后,我还没有出门。
对方问:“你不是说五分钟吗?”
我说:“马上,真的马上。”
“你每次说马上,我都不知道到底要等多久。”
“这次是真的。”
“行,我再相信你一次。”
这种对话,在生活里其实很常见。
有时候我们说“五分钟”,并不一定真的代表三百秒。
“马上”“等一下”“快了”,这些词在不同情况下,表达的时间可能完全不一样。
走到楼下,我突然发现外面比想象中热。
“今天怎么这么热?”
旁边的人说:“刚才不是还好吗?”
“刚才在屋里,没感觉。”
“要不我们开车?”
“这么近还开车?”
“那你刚才还说热。”
“热是热,但也没必要开车。”
“所以到底走还是开?”
“走吧。”
“确定?”
“确定。”
走了不到两分钟。
“要不……还是开车吧。”
“你看,我就知道。”
有时候改变主意并不需要多长时间。
尤其是在天气很热的时候。
吃饭的时候,服务员拿着菜单过来。
“您好,请问现在点餐吗?”
“可以。”
“有什么忌口吗?”
“没有特别忌口的,不过不要太辣。”
“微辣可以吗?”
“可以,稍微有一点就行。”
“这个需要吗?”
“这个是什么?”
“这是今天刚到的,比较新鲜。”
“那来一份吧。”
“还需要别的吗?”
我看了一遍菜单。
“这个是不是有点多了?”
“如果两个人吃的话,差不多。”
“那先这些,不够再加。”
“好的。”
过了一会儿,菜上来了。
我尝了一口。
“这个味道不错。”
“是吧?我就说可以。”
“不过好像有点辣。”
“这也叫辣?”
“对你来说当然不辣。”
“要不要给你拿点水?”
“不用,还能接受。”
吃东西这件事情很有意思。
同样一道菜,有人觉得咸,有人觉得淡;有人觉得刚刚好,还有人觉得完全吃不下。
很多感受,本来就没有统一标准。
下午有人给我发了一张照片。
我看了一会儿,问:
“这是哪里?”
“你猜。”
“我怎么猜?”
“你肯定去过。”
“我去过的地方多了。”
“再仔细看看。”
我把照片放大。
“等等,这个地方……我好像真的见过。”
“想起来了吗?”
“是不是上次我们去的那个地方?”
“哪个地方?”
“就是山下面有一条路,旁边还有一排树的那个。”
“对,就是那里。”
“变化这么大?”
“我刚看到的时候也吓了一跳。”
“什么时候拍的?”
“今天上午。”
“真的?”
“当然是真的,我骗你干什么?”
有时候一张照片就能把很久以前的记忆突然拉回来。
原本已经忘记的事情,因为一个熟悉的画面,又会一点一点想起来。
傍晚的时候,我准备把今天剩下的事情处理完。
刚坐下,就发现一个文件找不到了。
“奇怪,刚才明明还在这里。”
我把桌面找了一遍。
没有。
下载文件夹看了一遍。
还是没有。
“不会被我删了吧?”
我想了想。
“不对,我应该没有删。”
于是重新打开最近使用的文件。
还是没找到。
这时候我开始有点怀疑自己。
“我到底保存了吗?”
再想一遍。
应该保存了。
可是保存到哪里了?
我打开另外一个文件夹。
没有。
再打开一个。
还是没有。
正准备重新做的时候,我突然看到桌面的右下角。
文件就在那里。
我愣了一下。
“原来在这儿。”
找了半天,结果东西一直就在眼前。
这种事情发生的时候,往往让人又好气又好笑。
晚上接到一个电话。
“喂,到家了吗?”
“到了,刚回来。”
“今天怎么样?”
“还行,就是有点累。”
“事情处理完了吗?”
“大部分处理完了,还有一点明天再弄。”
“那就别弄了,早点休息。”
“我也是这么想的。”
“你每次都这么说。”
“什么意思?”
“嘴上说早点休息,最后还是很晚才睡。”
“今天不会。”
“真的?”
“真的。”
“几点睡?”
我停了一下。
“十一点半以前。”
“你确定?”
“……尽量。”
“看吧,我就知道。”
“十一点半确实有点早。”
“那你刚才还说确定?”
“人总要有个目标嘛。”
“行,那我明天问你。”
“别问了。”
“为什么?”
“因为我突然觉得这个目标可能有点难。”
说完,两个人都笑了。
生活里的很多对话,并没有什么重要内容。
“吃了吗?”
“去哪儿?”
“什么时候回来?”
“这个怎么样?”
“你确定吗?”
“真的?”
“为什么?”
“然后呢?”
“后来怎么样了?”
这些很短的问题,反而是我们每天说得最多的话。
有时候一句“知道了”,可以表示真的明白了。
也可以表示:
“行了,别说了,我已经知道了。”
一句“可以”,可能是非常肯定的:
“可以,就这么定。”
也可能只是勉强接受:
“嗯……也可以吧。”
同样是“没事”,语气不同,意思也完全不一样。
有人问:
“刚才没弄疼你吧?”
你回答:“没事。”
这是真的没关系。
可如果有人迟到了一个小时,然后问:
“你没生气吧?”
你停一下,再回答:
“没事。”
那可能就真的有事了。
再换几个不同的情况。
“准备好了吗?”
“准备好了,开始吧。”
“听清楚了吗?”
“听清楚了。”
“需要再说一遍吗?”
“不用了,我明白。”
“这个确定没有问题?”
“目前看没有问题。”
“什么时候能完成?”
“如果顺利的话,今天晚上。”
“如果不顺利呢?”
“那就明天。”
“有没有更快的方法?”
“有,但不一定更稳。”
“你建议哪个?”
“我建议先用稳妥的方法。”
“为什么?”
“因为这件事情没必要冒险。”
“好,就按你说的办。”
现在换一种情况。
“等一下。”
“怎么了?”
“好像不太对。”
“哪里不对?”
“我也说不上来,让我再看一下。”
“是不是这里?”
“不对,不是这个。”
“那会不会是前面的问题?”
“有可能。”
“要不要重新来一次?”
“先别动。”
“为什么?”
“我想先把原因找出来。”
“找到了吗?”
“等等……找到了。”
“什么问题?”
“很简单,一个地方设置错了。”
“就这个?”
“对,就这个。”
“折腾这么久?”
“所以说,问题越小,有时候越难发现。”
最后再读一组非常短的自然表达。
好的。
可以。
没问题。
知道了。
明白。
等一下。
稍等。
马上。
别着急。
慢一点。
再来一次。
先别动。
让我看看。
我想一下。
应该可以。
不一定。
有可能。
我不知道。
你确定吗?
真的吗?
为什么?
什么时候?
在哪里?
然后呢?
还有吗?
就这些?
这么快?
这么多?
不会吧?
原来如此。
我明白了。
差不多。
还可以。
挺好的。
非常好。
太好了!
终于好了!
这就对了。
不对。
还是不对。
有点奇怪。
怎么回事?
别担心。
没关系。
没什么。
不用了,谢谢。
麻烦你了。
辛苦了。
回头再说。
明天见。
晚点联系。
好的,就这样。
最后用最自然的状态读下面几句话:
今天的事情基本处理完了。
虽然中间出现了一点小问题,不过最后还是解决了。
有些事情第一次做的时候会觉得很复杂,熟悉以后就会简单很多。
遇到问题不用急着下结论,先看看发生了什么,再决定下一步怎么办。
如果今天没有完成,那就明天继续。
只要方向没有错,慢一点也没有关系。
好了,今天先到这里。
第二组录音结束。
🌱 第三组|数字、时间、日期与复杂中文表达
今天早上醒来的时候,我看了一眼时间。
七点二十三分。
本来打算七点起床,结果还是多睡了二十多分钟。
我想了一下,时间应该还来得及。
洗漱大概需要十五分钟,吃早饭十分钟,收拾东西再用五分钟。如果八点以前能够出门,基本不会耽误后面的安排。
结果真正出门的时候,已经八点零六分了。
有时候计划得很准确,真正做起来却完全是另外一回事。
走到楼下,我看了一眼手机。
今天是二〇二六年九月二日,星期三。
九月份刚刚开始,今年已经过去了大半。
仔细想想,一年其实没有想象中那么长。
一月份的时候还觉得新的一年刚刚开始,到了三月份,天气慢慢变暖;五月、六月过去以后,很快就到了七月和八月。
再往后就是九月、十月、十一月和十二月。
一年十二个月,三百六十五天。
如果遇到闰年,就是三百六十六天。
一天二十四小时,一小时六十分钟,一分钟六十秒。
这些数字平时都很熟悉,但真正认真去想的时候,会发现时间就是这样一点一点过去的。
上午九点半,我准备去买点东西。
到了商店以后,我先拿了一瓶水。
价格是三元五角。
又拿了一盒牛奶,十二元八角。
旁边还有一袋面包,标价九元九角。
我想了想,又拿了两袋。
结账的时候,店员说:
“一共三十六元一角。”
我问:
“可以手机付款吗?”
“可以。”
付款以后,我看了一眼余额,没有问题。
走出商店的时候,我突然想到,刚才是不是忘了买纸巾?
想了一下。
算了,下次再买。
中午吃饭的时候,菜单上有一道菜,价格四十八元。
另外一道三十二元。
米饭每份三元。
饮料八元一瓶。
如果两个人吃饭,点两个菜、两份米饭,再加两瓶饮料,总价大概是一百零二元。
如果再加一道二十六元的菜,就是一百二十八元。
当然,真正结账的时候,还要看有没有优惠。
有时候满一百减十元,有时候可以打九折,也有时候第二件半价。
九折,就是原价的一百分之九十。
八五折,就是原价的一百分之八十五。
如果一件商品原价二百元,打九折以后是一百八十元。
如果原价八百元,打八折以后就是六百四十元。
这些计算并不复杂,但买东西的时候,我们经常会遇到。
下午,我准备开车去一个地方。
导航显示,全程十二点八公里。
预计需要二十七分钟。
其中前面三点五公里比较拥堵,大约需要十二分钟。
后面的道路比较顺畅。
导航提醒我:
“前方五百米右转。”
继续往前。
“前方二百米进入左侧车道。”
到了路口以后,我看了一眼路牌。
左边是人民路,右边是建设路。
我要去的地方在建设路北侧,大概再往前一公里。
经过第二个红绿灯以后右转,再走三百米,就能看到入口。
停车场在建筑物的地下二层。
入口限高两米。
我的车没有问题,可以正常进入。
停好车以后,我看了一眼车位。
负二层,三排,一百二十六号。
我在手机里简单记了一下:
地下二层,三排,一二六。
因为有时候进去的时候觉得自己肯定能记住,几个小时以后出来,就完全不知道车停在哪里了。
尤其是比较大的停车场。
A区、B区、C区,再加上一层、二层、三层,如果没有记下来,找车确实很麻烦。
所以现在我一般都会顺手拍张照片。
这样最简单。
到了楼上,对方问我:
“你几点到的?”
我说:
“大概两点四十分。”
“路上堵吗?”
“前面有一点,后面还好。”
“开了多长时间?”
“差不多半个小时。”
“你从家里几点出来的?”
“两点十分左右。”
“那还挺快。”
“今天路上车不算多。”
我们约的时间原本是下午三点。
我提前了大约二十分钟到。
如果是比较重要的事情,我一般不太喜欢踩着时间到。
提前十分钟或者十五分钟,会更从容一些。
处理事情的时候,对方给了我一份数据。
第一个数字是百分之六十二点五。
第二个是百分之七十八。
第三个是百分之八十三点六。
第四个接近百分之九十。
我看了一下,说:
“第二个和第三个差了五点六个百分点。”
对方说:
“对,最近提高得比较明显。”
如果从百分之六十提高到百分之八十,看起来只增加了二十个百分点,但实际变化已经很大。
数据有时候很直观。
不过单独看一个数字,也不一定能说明全部问题。
最好还是把前后的情况放在一起比较。
再看另外一组数字。
一百二十八。
二百五十六。
五百一十二。
一千零二十四。
两千零四十八。
四千零九十六。
这些数字越来越大。
再换一些不规则的数字。
十七。
四十三。
六十八。
九十五。
一百零七。
三百零六。
五百八十九。
一千二百零三。
三千零八十五。
一万零六十。
三万五千二百八十一。
十二万零六百四十。
一百零八万三千二百五十六。
读比较大的数字时,不用故意放慢,按照平时说话的速度就可以。
下面再说几个小数。
零点五。
一点二。
三点一四。
十二点五。
二十八点六。
一百零三点八。
零点零五。
零点零八。
一点零六。
二十点零三。
一百二十八点五七。
同一个数字放在不同场景里,意思可能完全不同。
三点五,可以表示三点五元。
也可以表示三点五公里。
还可以表示三点五公斤。
如果说现在是三点五分,那又是另外一种表达。
所以真正说话的时候,数字通常都会和前后的内容连在一起。
我买了一袋大米,重量是五公斤。
一瓶饮料五百毫升。
一盒牛奶二百五十毫升。
房间面积大约九十平方米。
桌子长度一米二。
门的高度大约两米。
今天最高温度三十二摄氏度。
最低温度二十四摄氏度。
车速六十公里每小时。
前方距离目的地还有八点三公里。
手机电量剩余百分之四十七。
文件大小大约二百八十兆。
下载已经完成百分之七十五。
剩余时间大约六分钟。
这些都是日常生活里经常会出现的数字表达。
再说说年龄和年份。
一个孩子今年七岁,明年就是八岁。
一个人一九九〇年出生,到二〇二六年是三十六岁左右。
当然,具体年龄还要看生日有没有过。
一九八〇年到一九八九年出生的人,我们平时经常称为八零后。
一九九〇年到一九九九年出生的人,通常叫九零后。
进入二十一世纪以后,二〇〇〇年、二〇〇一年、二〇〇二年,这些年份听起来离现在好像也没有那么远了。
时间往往就是这样。
当时觉得很久,回头一看,已经过去很多年。
下面读几个日期。
一月一日。
二月十四日。
三月十二日。
五月一日。
六月一日。
七月一日。
八月十五日。
九月十日。
十月一日。
十一月十一日。
十二月三十一日。
二〇二四年五月二十八日。
二〇二五年十二月十六日。
二〇二六年九月二日。
二〇二七年一月十八日。
日期也可以换一种自然说法。
五月二十八号。
九月二号。
十二月十六号。
下个月十五号。
这个星期五。
下个星期三。
明天下午。
后天上午。
三天以后。
两个星期以后。
半年以后。
明年这个时候。
下面是时间。
早上六点。
上午八点半。
上午十一点二十分。
中午十二点整。
下午一点十五分。
下午三点四十五分。
傍晚六点十分。
晚上八点半。
晚上十点五十五分。
凌晨零点。
凌晨一点零五分。
凌晨三点二十分。
还有一些更自然的说法。
六点左右。
八点多。
差十分九点。
十二点刚过。
一点半左右。
三点不到。
五点多一点。
七点半以前。
九点以后。
大概十点钟。
十一点左右应该可以结束。
有时候时间不用说得特别准确。
别人问:
“你什么时候回来?”
我可能会回答:
“七八点吧。”
别人问:
“还要多久?”
我会说:
“十几分钟。”
如果对方继续问:
“到底十分钟还是二十分钟?”
我可能会回答:
“差不多十五分钟,你别着急。”
这才是生活里更常见的数字表达。
下面换成数量。
一个人。
两个人。
三个人。
十个人。
二十多人。
一百多人。
几百个人。
一千多人。
一万多人。
一辆车。
两辆车。
十几辆车。
几十辆车。
一百多辆车。
一本书。
两本书。
十二本书。
三十多本书。
一百零五本书。
一杯水。
半杯水。
两杯水。
三瓶水。
六盒牛奶。
八个苹果。
十五个橘子。
二十八张照片。
一百二十六个文件。
有些数量并不需要特别精确。
比如:
“大概有二十个人。”
“差不多三十公里。”
“估计还要一个小时。”
“可能需要两三天。”
“至少要一个星期。”
“最多半个月。”
“差不多一半。”
“只有三分之一。”
“大约四分之三。”
“超过百分之八十。”
“不到百分之十。”
这些表达,在真正说话的时候比精确数字使用得更多。
晚上回家的时候,我看了一眼今天走的步数。
八千六百三十二步。
距离大约六点三公里。
手机显示今天活动时间一小时二十八分钟。
我想了一下,今天好像确实走了不少路。
不过这些数字只是一个记录。
八千步不代表今天一定比七千步更好。
有时候走得少一点,是因为一直在认真做一件事情。
有时候走得多,只是因为出去办了很多事情。
数字可以帮助我们了解情况,但没有必要让所有事情都变成数字。
最后再读一组比较完整的句子。
会议原计划上午九点开始,后来推迟到了九点二十分。
从这里到目的地大约十八公里,正常情况下需要三十五分钟。
这个房间大约二十五平方米,可以坐十二到十五个人。
今天一共收到二十八条消息,其中十六条已经回复,还有十二条没有处理。
这份文件一共有一百二十页,我已经看到了第八十六页。
整个任务大概完成了百分之七十二,剩下的部分预计明天下午完成。
第一种方案需要三天,第二种方案需要五天,第三种方案虽然只需要两天,但风险相对更高。
如果预算从五千元增加到八千元,可以选择的范围会大很多。
这个东西原价一千二百九十九元,现在优惠以后是九百九十九元。
从上午八点四十分开始,到下午四点二十分结束,中间一共用了七个小时四十分钟。
数字本身并不复杂。
真正复杂的是,我们每天都会在不同的场景里使用它们。
时间、价格、距离、重量、数量、日期、年龄、温度、比例,每一种表达都有自己的习惯。
所以这一组并不是为了把数字念得特别标准。
还是和前面一样,用平时说话的方式,自然地把它说出来就可以。
不用追求速度,也不用刻意放慢。
读错了,停一下。
重新把这一句话读一遍。
然后继续往下。
第三组录音到这里结束。
🌱 第四组|自然情绪与真实表达
🌱 一、平静
今天没有什么特别的安排。
上午把手头的事情处理一下,下午如果有时间,我准备出去走走。
天气看起来还不错,外面有一点风。
其实这样的日子也挺舒服。
不用赶时间,也没有什么事情催着自己。
想做什么,就慢慢做。
累了就休息一会儿。
有些事情今天做不完,明天继续也可以。
生活不可能每天都特别精彩。
大部分时间,其实就是这样平平常常地过去。
🌱 二、轻松
今天事情不算多。
本来以为要忙一整天,结果上午就解决得差不多了。
剩下的事情不着急。
我给自己倒了一杯水,坐下来看看还有没有遗漏。
没有。
挺好。
难得今天这么顺利。
那下午就不用一直坐在这里了。
出去走走,或者找个地方吃点东西。
偶尔给自己放松一下,也没什么不好。
🌱 三、高兴
刚才收到一个消息。
我看了两遍才确定自己没有看错。
真的通过了!
太好了。
这个事情已经等了挺长时间。
之前一直不知道什么时候能有结果。
今天突然看到消息的时候,我第一反应还有点不敢相信。
我又确认了一遍。
没错。
就是这个。
终于等到了。
说实话,这一刻确实挺高兴。
之前花的时间,总算没有白费。
🌱 四、惊喜
等一下。
这是真的吗?
你什么时候准备的?
我完全不知道。
难怪你这两天一直神神秘秘的。
我还以为发生什么事情了。
原来是在准备这个。
真的没有想到。
你居然一直没告诉我。
让我再看看。
这个确实挺不错。
谢谢。
这个惊喜我收到了。
🌱 五、期待
还有三天。
想想还真有点期待。
之前计划了那么久,现在终于快到了。
东西基本都准备好了。
该带的也检查了一遍。
应该没有遗漏什么。
不过每次到这种时候,我还是会忍不住再检查一次。
证件带了吗?
带了。
手机、充电器,都有。
其他东西就算忘了,应该也不是什么大问题。
现在就等出发了。
🌱 六、疑惑
奇怪。
这个地方好像不太对。
刚才明明还是正常的。
怎么突然变成这样了?
我先看看。
不是这里。
这里也没问题。
那问题到底出在哪儿?
等等。
是不是刚才改过一个设置?
让我想一下。
对,我刚才确实动过这里。
难道是这个原因?
先改回来试试。
🌱 七、发现问题后的恍然大悟
哦。
原来是这样。
我知道问题在哪儿了。
怪不得刚才怎么试都不对。
前面的步骤没有问题,最后这个地方弄反了。
改过来就行。
再试一次。
好了。
这次正常了。
折腾这么长时间,原来就是这么一个小问题。
早发现就好了。
不过至少现在解决了。
🌱 八、轻微着急
等一下,先别关。
我这里还没有保存。
等我一下。
好了没有?
再等几秒钟。
马上。
好了,现在可以了。
刚才差一点。
如果直接关掉,前面做的东西可能就没了。
以后这种情况还是先确认一下比较好。
别急着点。
先看看有没有保存成功。
🌱 九、真正着急,但不要喊
电话怎么一直没人接?
再打一次。
还是没人接。
怎么回事?
刚才不是还说马上回来吗?
已经过去半个多小时了。
消息也没有回。
是不是手机没电了?
还是在开车?
算了,再等五分钟。
如果还是没有消息,我再打一次。
应该没什么事。
先等等。
🌱 十、松一口气
回消息了。
原来刚才一直在开车。
我就说怎么电话也不接,消息也不回。
没事就好。
刚才确实有点担心。
现在知道情况就行了。
慢慢回来,不用着急。
路上注意安全。
到了以后告诉我一声。
🌱 十一、无奈
又来了。
这个问题昨天不是刚解决吗?
怎么今天又出现了?
我真的有点想不明白。
每次以为已经彻底弄好了,过一会儿又出问题。
算了。
抱怨也没用。
还是重新检查吧。
先看看是不是和昨天一样。
如果是同一个原因,应该很快就能解决。
如果不是,那就只能继续找。
🌱 十二、轻微不满
我觉得这件事情还是应该提前说一声。
不是说不能改。
可以改。
但至少应该让我知道。
现在东西都已经准备好了,突然告诉我整个方案变了,我这边很多事情都要重新做。
如果昨天告诉我,其实完全来得及。
现在再改,就比较麻烦了。
下次如果有这种情况,麻烦早点告诉我。
这样大家都方便。
🌱 十三、轻微生气
我刚才已经说过了。
这个东西先不要动。
为什么还是改了?
如果不确定,可以先问我。
现在的问题不是改错了多少,而是我们根本不知道刚才到底改了哪些地方。
这样排查起来会非常麻烦。
先别继续操作。
把现在的状态保留下来。
我们一项一项检查。
🌱 十四、控制住情绪后的严肃
这件事情我还是想认真说一下。
问题出现并不可怕。
谁都有可能出错。
但出了问题以后,至少应该把情况说明白。
哪里出了问题,什么时候发现的,之前做过哪些操作,这些都应该讲清楚。
如果什么都不知道,只告诉我一句“不能用了”,那谁也没办法判断原因。
以后遇到类似情况,先把信息留下来。
不要急着乱改。
这是最基本的。
🌱 十五、失望
结果出来了。
还是没有通过。
说完全不失望,那肯定不是真的。
毕竟准备了这么长时间。
之前也觉得这次应该差不多了。
没想到最后还是这个结果。
不过事情已经这样了。
先看看具体是什么原因吧。
如果还有机会修改,那就重新调整。
如果确实没有办法,也只能接受。
至少这次知道问题在哪里。
🌱 十六、低落但克制
今天状态不太好。
也说不上来到底因为什么。
就是觉得有点累。
不太想说话,也不太想做事情。
可能只是这几天没有休息好。
没关系。
今天早点结束。
该放下的事情先放一放。
睡一觉。
明天起来以后再看。
很多事情到了第二天,感觉可能就不一样了。
🌱 十七、安慰别人
没关系。
一次没做好,不代表以后也做不好。
你已经准备很长时间了,这些努力不会因为一次结果就全部没有意义。
先别急着想下一步。
今天就好好休息。
等情绪过去以后,我们再看看究竟哪里需要调整。
能解决的就解决。
解决不了的,再想其他办法。
事情总会有办法的。
🌱 十八、温柔
慢一点。
不用着急。
我在这里等你。
东西忘了也没关系,我们可以回去拿。
时间还来得及。
你先看看是不是还有什么没有带。
想好了我们再走。
不用怕耽误时间。
今天本来也没有那么赶。
准备好了告诉我。
🌱 十九、对孩子说话的自然状态
你先过来。
我看看怎么回事。
哪里弄疼了?
这里吗?
没关系,让我看一下。
好了,没有什么大问题。
下次跑的时候慢一点。
我知道你着急,但着急也不能不看路。
好了,不说你了。
起来试试看。
还能走吗?
可以?
那就好。
🌱 二十、鼓励
再试一次。
刚才已经比第一次好多了。
不要总想着一定要一次成功。
先把最简单的部分做好。
然后一点一点往后加。
你现在已经知道前面哪里有问题了。
下一次肯定会更快。
来。
再试一次。
这次慢一点。
对。
就是这样。
🌱 二十一、肯定
这个做得不错。
比上一次明显好很多。
尤其是前面这一部分,基本没有问题了。
后面还有几个小地方需要调整,但都不是什么大问题。
不用全部重新来。
把这几个地方改一下就可以。
整体方向是对的。
继续按照这个方法做。
🌱 二十二、犹豫
这个……
让我想一下。
现在让我马上决定,我还真有点拿不准。
第一种方法比较稳,但是时间长。
第二种方法快一些,不过风险也更高。
如果只是我自己的事情,我可能会选第二种。
但这次涉及的东西比较多。
还是稳一点吧。
对。
就选第一种。
🌱 二十三、拒绝
不用了。
这个我暂时不需要。
不是东西不好,是现在确实用不上。
如果以后有需要,我会再考虑。
今天就先这样。
谢谢。
不用再介绍了。
我已经了解得差不多了。
🌱 二十四、礼貌请求
麻烦你帮我看一下这个。
不用现在马上处理。
你有时间的时候看就可以。
主要是帮我确认一下这里有没有问题。
如果没有问题,我就继续往下做。
如果需要调整,你直接告诉我哪里需要改。
谢谢。
🌱 二十五、解释
不是这个意思。
我重新说一下。
我想表达的是,我们现在不用急着把所有东西全部做完。
先把最关键的部分跑通。
确定整个流程没有问题以后,再慢慢增加其他功能。
这样即使中间出现问题,也比较容易找到原因。
如果一开始把所有东西都加进去,出了问题以后反而不知道从哪里查。
这样解释应该比较清楚了。
🌱 二十六、不同程度的确认
嗯。
知道了。
好。
好的。
可以。
没问题。
确定。
我确定。
对,就是这个。
没错。
应该是这样。
我觉得可以。
目前看没有问题。
那就这么定。
好,就按照这个方案来。
🌱 二十七、不同程度的否定
不是。
不对。
不是这个。
应该不是。
我觉得不太对。
这里肯定有问题。
先不要这样做。
这个方法可能不行。
我不建议现在改。
暂时不要动。
等确认以后再说。
不行,这个必须重新处理。
🌱 二十八、不同程度的惊讶
嗯?
什么?
真的?
这么快?
已经好了?
不会吧?
你确定?
真的假的?
怎么可能?
等一下,让我看看。
还真是。
我完全没想到。
这确实有点意外。
🌱 二十九、不同程度的高兴
不错。
挺好的。
很好。
真的挺不错。
这次可以。
终于正常了。
这就对了。
太好了。
终于解决了!
真的成功了!
不错,今天总算没有白忙。
🌱 三十、自然收尾
今天录了不少内容。
说到现在,确实有一点累了。
不过整体状态还可以。
前面有比较平静的内容,也有高兴、着急、失望和严肃的时候。
这些情绪在生活里都很正常。
一个人说话也不会永远保持同一种状态。
有时候声音轻一点。
有时候会快一点。
有时候因为高兴,声音自然会提高。
有时候心情不好,说话又会慢下来。
真正自然的声音,本来就应该有这些变化。
现在这一组已经接近结束。
我不用刻意调整自己的声音。
也不用为了录音,把每一个字都说得特别标准。
保持平时说话的状态就可以。
好了。
今天的第四组录音,到这里结束。
扫码访问小程序中的本文